Practicar conversaciones difíciles con una IA mejora habilidades, pero no sustituye al paciente humano
Un ensayo aleatorizado detecta mejoras en empatía, claridad y participación del paciente tras 30 minutos con un paciente virtual generativo. La prueba sigue siendo pequeña y simulada.
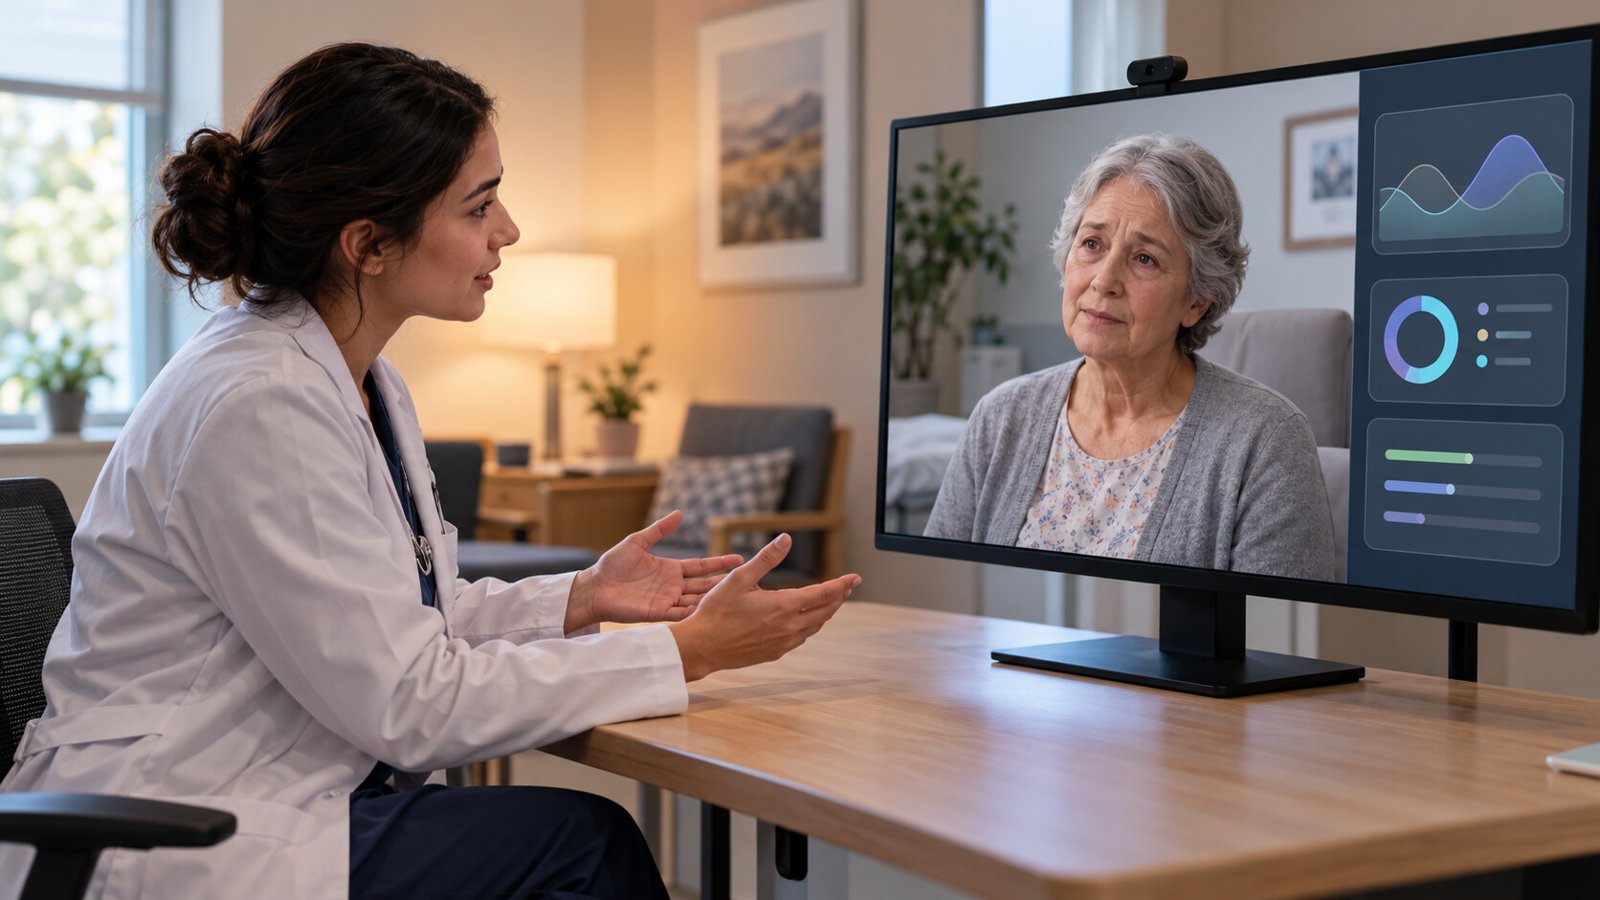
Imagen ilustrativa incluida en el documento facilitado.
En breve
Un ensayo aleatorizado detecta mejoras en empatía, claridad y participación del paciente tras 30 minutos con un paciente virtual generativo. La prueba sigue siendo pequeña y simulada.
Datos clave
- Participantes
- 51 estudiantes y profesionales sanitarios, asignados a SOPHIE o a materiales escritos.Fuente: JMIR Medical Education
- Resultado
- La mejora adicional en la puntuación global normalizada fue de 0,09 puntos (IC95%: 0,04-0,14).Fuente: JMIR Medical Education
- Cautela
- Una sesión no demuestra retención, transferencia a consultas reales ni equivalencia con actores entrenados.Fuente: JMIR Medical Education
Ensayar una conversación que no admite improvisación
Comunicar un pronóstico grave, responder a la emoción y construir un plan acorde con los valores del paciente exige práctica deliberada. Sin embargo, los pacientes estandarizados humanos —actores entrenados para simular una consulta— son costosos y no siempre están disponibles. SOPHIE propone ampliar ese entrenamiento con una paciente virtual basada en inteligencia artificial generativa.
El ensayo comparó 30 minutos de interacción con el sistema frente a 30 minutos de lectura sobre el mismo marco de comunicación. Actores y evaluadores independientes, cegados a la asignación, puntuaron conversaciones simuladas antes y después de la formación.
Qué hace SOPHIE
El sistema representa a una mujer de 60 años con cáncer de pulmón avanzado. Combina reconocimiento de voz, un gestor de diálogo híbrido, un modelo de lenguaje, síntesis de voz y un avatar. Las respuestas se apoyan en esquemas clínicos que marcan el recorrido esperado, y el modelo generativo aporta naturalidad.
La formación se divide en tres habilidades: empatizar, ser explícito y empoderar. Después de cada módulo, el usuario recibe comentarios sobre conductas eficaces, oportunidades perdidas y alternativas de formulación. No se pide al sistema que decida un tratamiento, sino ensayar cómo sostener una conversación clínica compleja.
Una señal de eficacia conductual
Participaron 51 personas entre estudiantes de medicina, enfermería y asistencia médica, además de profesionales en ejercicio. Veintiséis utilizaron SOPHIE y 25 revisaron materiales escritos. La mejora adicional del grupo de IA fue de 0,11 puntos en empoderamiento, 0,08 en claridad, 0,07 en empatía y 0,09 en la puntuación global, todas en escalas normalizadas.
El estudio reunió 102 conversaciones grabadas y 506 evaluaciones. Los actores desconocían el grupo asignado y cuatro evaluadores adicionales revisaron los vídeos sin conocer ni el grupo ni el orden temporal, lo que refuerza el resultado frente a estudios basados solo en satisfacción.
Un complemento escalable, no una equivalencia demostrada
El comparador fue una lectura estructurada, no un entrenamiento con pacientes estandarizados humanos. Por eso, el ensayo demuestra que la práctica interactiva superó a materiales pasivos en este contexto, pero no que el avatar sea igual o mejor que el estándar presencial. Tampoco permite saber si el efecto se mantiene semanas después.
La evaluación ocurrió en escenarios simulados y con una muestra pequeña. La novedad del sistema pudo aumentar la motivación, y el realismo del avatar recibió valoraciones más moderadas que la utilidad del feedback. Falta comprobar la transferencia a consultas reales y su funcionamiento entre especialidades, idiomas y culturas clínicas.
Cómo podría incorporarse con seguridad
Una implementación razonable utilizaría el paciente virtual para practicar más veces, preparar una sesión con actores o reforzar contenidos después de un taller. Los docentes deberían revisar guiones, criterios de feedback y respuestas ante situaciones inesperadas, además de definir qué datos de voz o vídeo se guardan.
Nota editorial: los resultados describen una intervención formativa breve y simulada; no demuestran impacto asistencial ni equivalencia con pacientes estandarizados.
— Redacción PulsoSalud
Fuentes y referencias
Autoría
Redacción PulsoSalud
Sección Salud digital.
Sigue leyendo
Contenidos relacionados
Datos del mundo real · Enfermedades raras
De registro a sistema que aprende: MEDA-PKD lleva la enfermedad renal rara al análisis casi en tiempo real
La plataforma alemana integra historia clínica, laboratorio, calidad de vida y proteómica para convertir una cohorte de poliquistosis renal en un recurso dinámico de investigación.
Leer
IA y salud · Seguridad clínica
Una IA fiable también puede inducir errores: la experiencia cambia cómo se vigila al algoritmo
Un estudio con 1.750 decisiones muestra que la seguridad no depende solo de la precisión del modelo, sino de cómo reaccionan los profesionales cuando la ayuda automatizada se equivoca.
Leer
IA generativa · Evaluación
Las métricas automáticas no bastan para evaluar mensajes clínicos generados por IA
En un despliegue real de UCLA, solo el 11% de los borradores visibles se incorporó al mensaje final y la similitud textual no reflejó la preferencia médica.
Leer¿Quieres recibir los próximos análisis?
Suscríbete al newsletter de PulsoSalud.