Una IA fiable también puede inducir errores: la experiencia cambia cómo se vigila al algoritmo
Un estudio con 1.750 decisiones muestra que la seguridad no depende solo de la precisión del modelo, sino de cómo reaccionan los profesionales cuando la ayuda automatizada se equivoca.
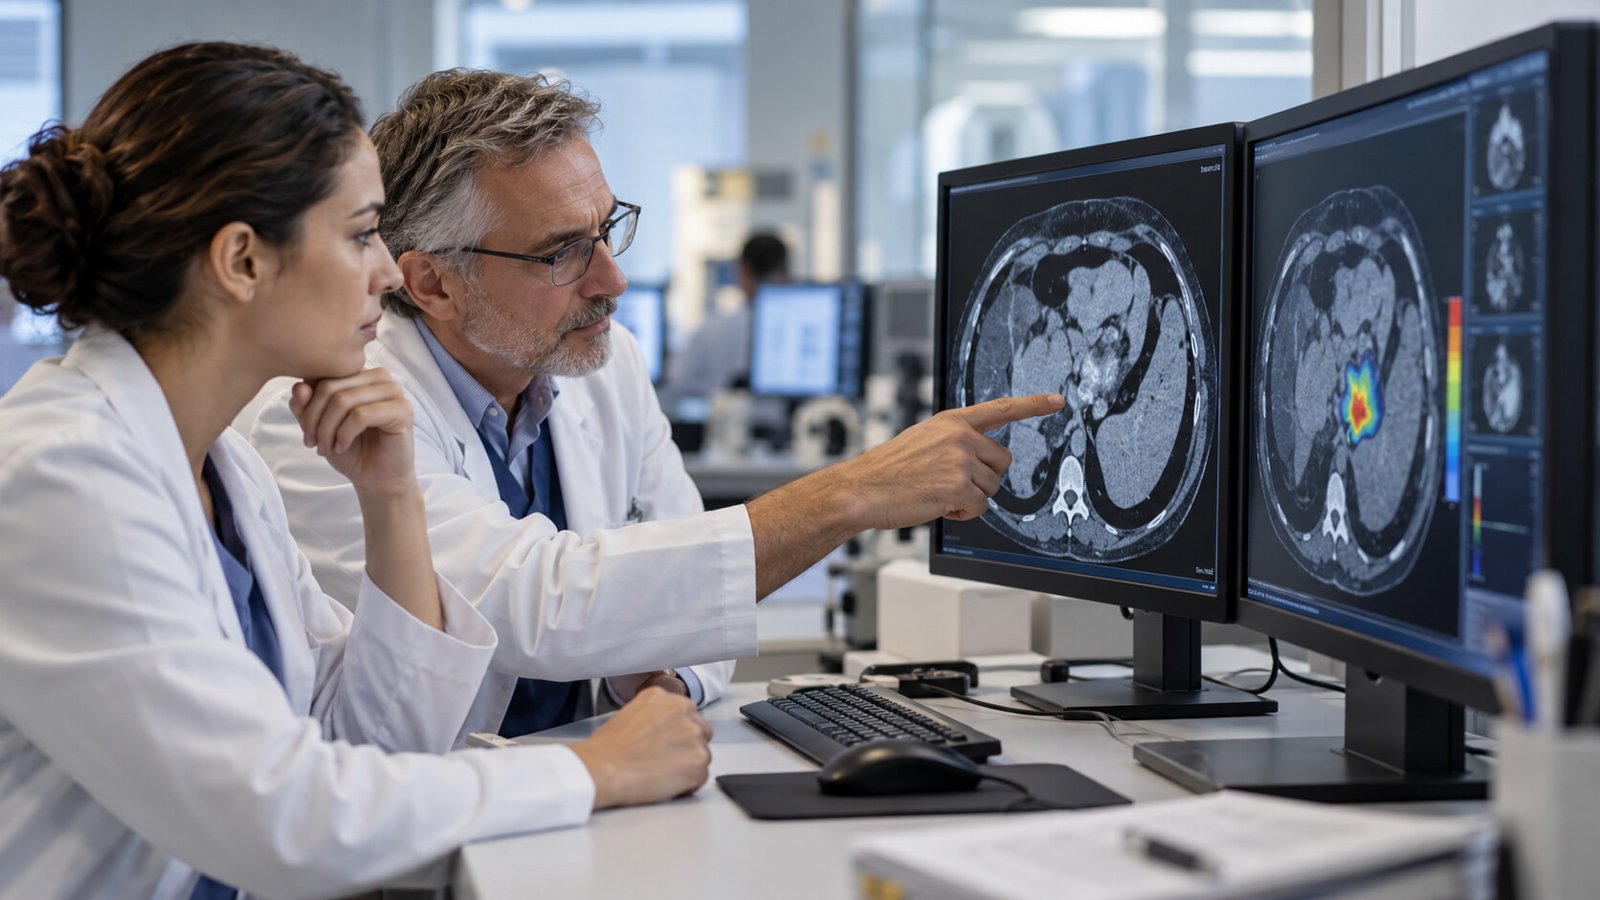
Imagen ilustrativa incluida en el documento facilitado.
En breve
Un estudio con 1.750 decisiones muestra que la seguridad no depende solo de la precisión del modelo, sino de cómo reaccionan los profesionales cuando la ayuda automatizada se equivoca.
Datos clave
- Diseño
- Catorce profesionales interpretaron 125 radiografías externas de 11 hospitales, con y sin ayuda de IA.Fuente: npj Digital Medicine
- Comparación
- Se enfrentaron a un asistente fiable y a otro con errores introducidos de forma deliberada.Fuente: npj Digital Medicine
- Clave
- Los perfiles menos expertos fueron más vulnerables al sesgo de automatización; los especialistas vigilaron mejor los fallos.Fuente: npj Digital Medicine
La paradoja de confiar en un sistema que casi siempre acierta
Una inteligencia artificial puede alcanzar un rendimiento alto y, aun así, crear un nuevo riesgo: que quien la utiliza deje de buscar activamente sus errores. El estudio publicado en npj Digital Medicine examinó esa interacción en el diagnóstico de neumoperitoneo neonatal, una urgencia radiológica donde una interpretación equivocada puede retrasar decisiones críticas.
El equipo analizó cómo cambiaban las decisiones sin asistencia, con una IA fiable y con una versión que incorporaba fallos deliberados, para observar qué sucede cuando el modelo falla delante de profesionales con distinta experiencia.
Un estudio sobre el equipo humano-IA
Participaron seis radiólogos pediátricos, tres neonatólogos y cinco residentes de radiología, que revisaron radiografías de una cohorte externa multicéntrica hasta completar 1.750 decisiones. Las dos ayudas compartían arquitectura; una estaba optimizada para un desempeño fiable y la otra se entrenó con etiquetas sesgadas para provocar errores sistemáticos.
La experiencia funciona como una capa de seguridad
Los especialistas mostraron mayor vigilancia cuando la IA se equivocaba. Los lectores menos expertos podían beneficiarse de la ayuda fiable, pero también eran más susceptibles de aceptar una indicación errónea. Una trayectoria de aciertos puede elevar la confianza y reducir la comprobación independiente.
Dos hospitales pueden obtener resultados distintos con la misma herramienta si cambian la formación, la presión asistencial, la interfaz, la experiencia de los usuarios o la forma de presentar la incertidumbre.
Qué debería medir un hospital antes de desplegarla
La evaluación local debe incluir el rendimiento del conjunto, no solo el AUC del algoritmo: cambios de decisión, falsos positivos y negativos aceptados, tiempo de lectura, capacidad de detectar errores y diferencias entre perfiles de experiencia. La formación debe entrenar la discrepancia: cuándo ignorar la recomendación, cómo volver a la imagen original y cómo escalar una duda.
Lo que el estudio no permite concluir
La muestra incluyó solo 14 lectores y una indicación clínica muy concreta. Los errores fueron creados experimentalmente y no representan toda la variedad de fallos reales. El subgrupo de neonatólogos fue especialmente pequeño y los análisis de mapas de saliencia fueron exploratorios. No se afirma que una IA precisa perjudique siempre ni que la experiencia elimine el sesgo de automatización.
— Redacción PulsoSalud
Fuentes y referencias
Autoría
Redacción PulsoSalud
Sección Salud digital.
Sigue leyendo
Contenidos relacionados
IA y salud · Formación clínica
Practicar conversaciones difíciles con una IA mejora habilidades, pero no sustituye al paciente humano
Un ensayo aleatorizado detecta mejoras en empatía, claridad y participación del paciente tras 30 minutos con un paciente virtual generativo. La prueba sigue siendo pequeña y simulada.
Leer
Datos del mundo real · Enfermedades raras
De registro a sistema que aprende: MEDA-PKD lleva la enfermedad renal rara al análisis casi en tiempo real
La plataforma alemana integra historia clínica, laboratorio, calidad de vida y proteómica para convertir una cohorte de poliquistosis renal en un recurso dinámico de investigación.
Leer
IA generativa · Evaluación
Las métricas automáticas no bastan para evaluar mensajes clínicos generados por IA
En un despliegue real de UCLA, solo el 11% de los borradores visibles se incorporó al mensaje final y la similitud textual no reflejó la preferencia médica.
Leer¿Quieres recibir los próximos análisis?
Suscríbete al newsletter de PulsoSalud.